ORM API 参考
模型
模型字段定义为模型自身的属性:
from odoo import models, fields
class AModel(models.Model):
    _name = 'a.model.name'

    field1 = fields.Char()
Warning
这意味着不能定义同名的字段和方法,后定义者会静默覆盖先前的定义。
默认情况下,字段的标签(用户可见名称)是字段名首字母大写的形式,可通过 string 参数覆盖。
field2 = fields.Integer(string="Field Label")
字段类型和参数的完整列表请参阅 字段参考。
默认值作为参数在字段上定义,可以是一个具体的值:
name = fields.Char(default="a value")
也可以是一个用于计算默认值的函数,该函数应返回该值:
def _default_name(self):
    return self.get_value()

name = fields.Char(default=lambda self: self._default_name())
API
AbstractModel
模型
TransientModel
字段
基本字段
高级字段
Date(time) 字段
Dates 和 Datetimes 是任何业务应用中都极为重要的字段。误用它们会产生隐蔽却令人痛苦的缺陷,本节旨在向 Odoo 开发者提供避免误用这些字段所需的知识。
给 Date/Datetime 字段赋值时,以下选项是有效的:
一个
date或datetime对象。符合正确服务器格式的字符串:
YYYY-MM-DD对应Date字段,YYYY-MM-DD HH:MM:SS对应Datetime字段。
False或None。
Date 和 Datetime 字段类提供辅助方法,可尝试将值转换为兼容类型:
to_date()会转换为datetime.dateto_datetime()会转换为datetime.datetime。
Example
解析来自外部来源的日期/日期时间:
fields.Date.to_date(self._context.get('date_from'))
Date / Datetime 比较最佳实践:
Date 字段 只能 与 date 对象比较。
Datetime 字段 只能 与 datetime 对象比较。
Warning
表示日期和日期时间的字符串可以互相比较,但结果可能并非预期,因为日期时间字符串总是大于日期字符串,因此 强烈 不建议这种做法。
与日期和日期时间相关的常见操作(如加减运算或获取周期的开始/结束)可通过 Date 和 Datetime 两者使用。这些辅助方法也可通过导入 odoo.tools.date_utils 获得。
Note
时区
Datetime 字段在数据库中以 timestamp without timezone 列存储,并以 UTC 时区保存。这是有意为之的设计,它使 Odoo 数据库独立于托管服务器系统的时区。时区转换完全由客户端管理。
关联字段
伪关联字段
计算字段
可以使用 compute 参数对字段进行计算(而非直接从数据库读取)。 必须由它将计算出的值赋给该字段 。如果它使用了其他 字段 的值,则应通过 depends() 指定这些字段。
from odoo import api
total = fields.Float(compute='_compute_total')

@api.depends('value', 'tax')
def _compute_total(self):
    for record in self:
        record.total = record.value + record.value * record.tax
使用子字段时,依赖可以是点号路径:
@api.depends('line_ids.value')
def _compute_total(self):
    for record in self:
        record.total = sum(line.value for line in record.line_ids)
计算字段默认不存储,而是在请求时计算并返回。设置
store=True会将其存入数据库并自动启用搜索。也可以通过设置
search参数在计算字段上启用搜索。其值是一个方法名,返回一个 搜索域。upper_name = field.Char(compute='_compute_upper', search='_search_upper') def _search_upper(self, operator, value): if operator == 'like': operator = 'ilike' return [('name', operator, value)]
搜索方法会在对模型执行实际搜索之前处理域时被调用。它必须返回一个等价于条件
field operator value的域。
计算字段默认为只读。要允许在计算字段上 设置 值,请使用
inverse参数。它是一个函数的名称,该函数会反转计算过程并设置相关字段:document = fields.Char(compute='_get_document', inverse='_set_document') def _get_document(self): for record in self: with open(record.get_document_path) as f: record.document = f.read() def _set_document(self): for record in self: if not record.document: continue with open(record.get_document_path()) as f: f.write(record.document)
多个字段可以由同一个方法同时计算,只需在所有字段上使用同一方法并全部设置:
discount_value = fields.Float(compute='_apply_discount')
total = fields.Float(compute='_apply_discount')

@api.depends('value', 'discount')
def _apply_discount(self):
    for record in self:
        # compute actual discount from discount percentage
        discount = record.value * record.discount
        record.discount_value = discount
        record.total = record.value - discount
Warning
虽然多个字段可以使用同一个 compute 方法,但不建议对 inverse 方法也这样做。
在计算反向方法的过程中,使用该反向方法的 所有 字段都会受到保护,也就是说即使它们的值不在缓存中,也不会被计算。
如果访问了其中任何一个字段且其值不在缓存中,ORM 会直接为这些字段返回默认值 False。这意味着反向字段(除触发反向方法的那个字段外)的值可能不是正确的值,这很可能会破坏反向方法的预期行为。
自动字段
- Model.id
标识符
field如果当前记录集的长度为 1,则返回其中唯一记录的 id。
否则抛出错误。
访问日志字段
如果启用了 _log_access,这些字段会被自动设置和更新。可以禁用它,以避免在不需要这些字段的表上创建或更新它们。
默认情况下,_log_access 的取值与 _auto 相同
- Model.create_date
存储记录的创建时间,
Datetime类型
- Model.create_uid
存储是 谁 创建了该记录,指向
res.users的Many2one字段。
- Model.write_date
存储记录的最后更新时间,
Datetime类型
- Model.write_uid
存储最后更新该记录的用户,指向
res.users的Many2one字段。
Warning
_log_access 在 TransientModel 上 必须 启用。
保留字段名
有一些字段名是为自动化字段之外的预定义行为保留的。当需要相关行为时,应在模型上定义它们:
- Model.name
_rec_name的默认值,用于在需要代表性”命名”的上下文中显示记录。Char
- Model.active
切换记录的全局可见性,如果
active设为False,记录在大多数搜索和列表中不可见。Boolean特殊方法:
- Model.state
对象的生命周期阶段,供
fields上的states属性使用。Selection
- Model.parent_id
_parent_name的默认值,用于将记录组织成树形结构,并在域中启用child_of和parent_of运算符。Many2one
- Model.parent_path
当
_parent_store设为 True 时,用于存储一个反映_parent_name树形结构的值,并优化搜索域中的child_of和parent_of运算符。必须以index=True声明才能正常工作。Char
- Model.company_id
Odoo 多公司行为使用的主字段名。
由
:meth:~odoo.models._check_company使用,用于检查多公司一致性。定义记录是在多个公司之间共享(无值),还是仅给定公司的用户可以访问。Many2one:type:res_company
记录集
与模型和记录的交互通过记录集进行,记录集是同一模型的记录的有序集合。
Warning
与名称的含义相反,目前记录集是可能包含重复项的。这一点将来可能会改变。
定义在模型上的方法会在记录集上执行,它们的 self 就是一个记录集:
class AModel(models.Model):
    _name = 'a.model'
    def a_method(self):
        # self can be anything between 0 records and all records in the
        # database
        self.do_operation()
对记录集进行迭代将产生 单条记录 的新集合(”单例”),就像对 Python 字符串进行迭代会产生单个字符的字符串一样:
def do_operation(self):
    print(self) # => a.model(1, 2, 3, 4, 5)
    for record in self:
        print(record) # => a.model(1), then a.model(2), then a.model(3), ...
字段访问
记录集提供”活动记录”(Active Record)接口:模型字段可以作为属性直接从记录读取和写入。
Note
当在可能包含多条记录的记录集上访问非关系型字段时,请使用 mapped():
total_qty = sum(self.mapped('qty'))
字段值也可以像字典项一样访问,对于动态字段名来说,这比 getattr() 更优雅也更安全。设置字段值会触发对数据库的更新:
>>> record.name
Example Name
>>> record.company_id.name
Company Name
>>> record.name = "Bob"
>>> field = "name"
>>> record[field]
Bob
Warning
尝试在多条记录上读取字段时,非关系型字段会引发错误。
访问关系型字段(Many2one、One2many、Many2many) 总是 返回一个记录集,如果字段未设置则为空记录集。
记录缓存与预取
Odoo 为记录的字段维护一个缓存,这样并非每次字段访问都会发起数据库请求——否则对性能来说将是灾难性的。以下示例只有第一条语句会查询数据库:
record.name             # first access reads value from database
record.name             # second access gets value from cache
为了避免一次只读取一条记录上的一个字段,Odoo 会按照一些启发式规则 预取 记录和字段,以获得良好的性能。一旦需要在某条给定记录上读取某个字段,ORM 实际上会在一个更大的记录集上读取该字段,并将返回的值存入缓存以备后用。被预取的记录集通常就是该记录通过迭代所处的记录集。此外,所有简单存储字段(boolean、integer、float、char、text、date、datetime、selection、many2one)会被一并获取;它们对应模型表的列,可以在同一查询中高效获取。
考虑下面的例子,其中 partners 是包含 1000 条记录的记录集。没有预取时,这个循环会对数据库发起 2000 次查询;有了预取,只会进行一次查询:
for partner in partners:
    print partner.name          # first pass prefetches 'name' and 'lang'
                                # (and other fields) on all 'partners'
    print partner.lang
预取同样适用于 次级记录:当读取关系型字段时,它们的值(即记录)会被订阅以供将来预取。访问其中一个次级记录会预取同一模型的所有次级记录。这使得下面的示例只产生两个查询,一个针对合作伙伴,一个针对国家:
countries = set()
for partner in partners:
    country = partner.country_id        # first pass prefetches all partners
    countries.add(country.name)         # first pass prefetches all countries
方法装饰器
环境
>>> records.env
<Environment object ...>
>>> records.env.uid
3
>>> records.env.user
res.user(3)
>>> records.env.cr
<Cursor object ...>
从另一个记录集创建记录集时,会继承其环境。可以使用环境获取其他模型的空记录集,并查询该模型:
>>> self.env['res.partner']
res.partner()
>>> self.env['res.partner'].search([('is_company', '=', True), ('customer', '=', True)])
res.partner(7, 18, 12, 14, 17, 19, 8, 31, 26, 16, 13, 20, 30, 22, 29, 15, 23, 28, 74)
有一些惰性属性可用于访问环境(上下文)数据:
实用的环境方法
修改环境
SQL 执行
环境上的 cr 属性是当前数据库事务的游标,允许直接执行 SQL,适用于难以用 ORM 表达的查询(例如复杂联接)或出于性能考虑的场景:
self.env.cr.execute("some_sql", params)
Warning
执行原生 SQL 会绕过 ORM,从而绕过 Odoo 的安全规则。请在使用用户输入时确保对查询进行净化处理,如果不是确实需要使用 SQL 查询,请优先使用 ORM 工具。
关于模型的一个重要事项是,它们不一定会立即执行数据库更新。实际上,出于性能考虑,框架会延迟修改记录之后字段的重新计算,一些数据库更新也会被延迟。因此,在查询数据库之前,必须确保数据库中包含查询所需的相关数据。这个操作称为 刷新 (flushing),它会执行预期的数据库更新。
Example
# make sure that 'partner_id' is up-to-date in database
self.env['model'].flush_model(['partner_id'])

self.env.cr.execute("SELECT id FROM model WHERE partner_id IN %s", [ids])
ids = [row[0] for row in self.env.cr.fetchall()]
在每条 SQL 查询之前,都必须刷新该查询所需的数据。刷新有三个级别,每个级别都有各自的 API。可以刷新全部内容、某个模型的所有记录,或某些特定记录。由于延迟更新总体上能提升性能,我们建议在刷新时做到 精确 。
由于模型使用相同的游标,且 Environment 持有多个缓存,在用原生 SQL 修改 数据库时必须使这些缓存失效,否则模型的后续使用可能会变得不一致。在 SQL 中使用 CREATE、UPDATE 或 DELETE 时需要清除缓存,而 SELECT 仅读取数据库)则不需要。
Example
# make sure 'state' is up-to-date in database
self.env['model'].flush_model(['state'])

self.env.cr.execute("UPDATE model SET state=%s WHERE state=%s", ['new', 'old'])

# invalidate 'state' from the cache
self.env['model'].invalidate_model(['state'])
与刷新一样,可以使整个缓存、某个模型所有记录的缓存,或特定记录的缓存失效,甚至可以使某些记录或模型所有记录上的特定字段失效。由于缓存总体上能提升性能,我们建议在失效时做到 精确 。
上述方法使缓存与数据库保持彼此一致。但是,如果计算字段的依赖项在数据库中被修改了,就必须告知模型,以便重新计算这些计算字段。框架需要知道的唯一信息是 哪些 记录上的 哪些 字段发生了变化。
Example
# make sure 'state' is up-to-date in database
self.env['model'].flush_model(['state'])

# use the RETURNING clause to retrieve which rows have changed
self.env.cr.execute("UPDATE model SET state=%s WHERE state=%s RETURNING id", ['new', 'old'])
ids = [row[0] for row in self.env.cr.fetchall()]

# invalidate the cache, and notify the update to the framework
records = self.env['model'].browse(ids)
records.invalidate_recordset(['state'])
records.modified(['state'])
必须弄清楚哪些记录被修改了。方法有很多,可能涉及额外的 SQL 查询。在上面的示例中,我们利用 PostgreSQL 的 RETURNING 子句在不额外查询的情况下检索到该信息。在通过失效操作使缓存保持一致后,在被修改的记录上调用 modified 方法并传入已更新的字段。
常用 ORM 方法
创建/更新
搜索/读取
字段
搜索域
域是一个条件列表,每个条件是一个三元组(list 或 tuple),形如 (field_name, operator, value),其中:
field_name(str)当前模型的字段名,或通过
Many2one以点表示法进行的关系遍历,例如'street'或'partner_id.country'
operator(str)用于比较
field_name与value的运算符。有效的运算符有:=等于
!=不等于
>大于
>=大于或等于
<小于
<=小于或等于
=?未设置或等于(如果
value为None或False则返回 true,否则行为与=相同)=like将
field_name与value模式进行匹配。模式中的下划线_代表(匹配)任意单个字符;百分号%匹配任意零个或多个字符的字符串。like将
field_name与%value%模式进行匹配。类似于=like,但在匹配前会用 ‘%’ 包裹valuenot like不匹配
%value%模式ilike不区分大小写的
likenot ilike不区分大小写的
not like=ilike不区分大小写的
=likein等于
value中的任意一项,value应为一个项的列表not in与
value中的所有项都不相等child_of是某条
value记录的子记录(后代)(value 可以是单个条目,也可以是条目列表)。考虑模型的语义(即沿
_parent_name所指定的关联字段进行)。parent_of是某条
value记录的父记录(祖先)(value 可以是单个条目,也可以是条目列表)。考虑模型的语义(即沿
_parent_name所指定的关联字段进行)。
value变量类型,必须可通过
operator与所命名的字段进行比较。
域条件可以使用 前缀 形式的逻辑运算符组合:
'&'逻辑 AND (与),默认的组合相继条件的操作。元数为 2(使用接下来的 2 个条件或组合)。
'|'逻辑 OR (或),元数为 2。
'!'逻辑 NOT (非),元数为 1。
Note
主要用于否定条件的组合。单个条件通常都有否定形式(例如
=->!=、<->>=),这比否定肯定式更简单。
Example
要搜索名称为 ABC、来自比利时或德国、且语言不是英语的合作伙伴:
[('name','=','ABC'),
 ('language.code','!=','en_US'),
 '|',('country_id.code','=','be'),
     ('country_id.code','=','de')]
该域将被解析为:
    (name is 'ABC')
AND (language is NOT english)
AND (country is Belgium OR Germany)
取消链接
记录(集)信息
- odoo.models.env
返回给定记录集的环境。
- Type
Environment
操作
记录集是不可变的,但同一模型的集合可以通过各种集合操作进行组合,返回新的记录集。
record in set返回record必须是单元素记录集)是否存在于set中。record not in set是其逆操作set1 <= set2和set1 < set2返回set1是否为set2的子集(后者为严格子集)set1 >= set2和set1 > set2返回set1是否为set2的超集(后者为严格超集)set1 | set2返回两个记录集的并集,即包含任一来源中所有记录的新记录集set1 & set2返回两个记录集的交集,即仅包含同时出现在两个来源中的记录的新记录集set1 - set2返回一个新记录集,仅包含set1中 不在set2里的记录
记录集是可迭代的,因此可以使用常规的 Python 工具进行转换(python:map()、python:sorted()、ifilter() 等),但这些工具返回的是 python:list 或 python:iterator,导致无法对其结果调用记录集方法,也无法使用集合操作。
因此,记录集提供了以下操作,这些操作(在可能的情况下)返回记录集本身:
过滤
映射
Note
自 V13 起,支持多级关联字段访问,其工作方式类似于 mapped 调用:
records.partner_id  # == records.mapped('partner_id')
records.partner_id.bank_ids  # == records.mapped('partner_id.bank_ids')
records.partner_id.mapped('name')  # == records.mapped('partner_id.name')
排序
继承与扩展
Odoo 提供了三种不同的机制,以模块化的方式扩展模型:
从现有模型创建新模型,在副本中添加新信息,但保持原模块不变
就地扩展其他模块中定义的模型,替换原有版本
将模型的部分字段委托给它所包含的记录
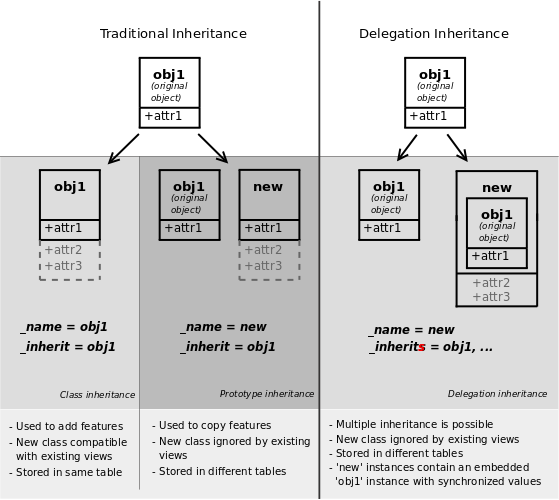
经典继承
同时使用 _inherit 和 _name 属性时,Odoo 会以现有模型(通过 _inherit 提供)为基类创建新模型。新模型会从其基类获取所有字段、方法和元信息(默认值等)。
class Inheritance0(models.Model):
    _name = 'inheritance.0'
    _description = 'Inheritance Zero'

    name = fields.Char()

    def call(self):
        return self.check("model 0")

    def check(self, s):
        return "This is {} record {}".format(s, self.name)

class Inheritance1(models.Model):
    _name = 'inheritance.1'
    _inherit = 'inheritance.0'
    _description = 'Inheritance One'

    def call(self):
        return self.check("model 1")
并使用它们:
a = env['inheritance.0'].create({'name': 'A'})
b = env['inheritance.1'].create({'name': 'B'})

a.call()
b.call()
将得到:
“这是模型 0 的记录 A” “这是模型 1 的记录 B”
第二个模型继承了第一个模型的 check 方法和 name 字段,但重写了 call 方法,就像使用标准 Python 继承 时一样。
扩展
使用 _inherit 而省略 _name 时,新模型会替换现有模型,实质上是就地扩展它。这适用于向现有模型(在其他模块中创建)添加新字段或方法,或者对其进行自定义或重新配置(例如更改其默认排序顺序):
class Extension0(models.Model):
_name = 'extension.0'
_description = 'Extension zero'

name = fields.Char(default="A")

class Extension1(models.Model):
_inherit = 'extension.0'

description = fields.Char(default="Extended")
record = env['extension.0'].create({})
record.read()[0]
将得到:
{'name': "A", 'description': "Extended"}
Note
它还会生成各种 自动字段,除非它们已被禁用
委托
第三种继承机制提供了更大的灵活性(可以在运行时更改),但功能较弱:使用 _inherits 时,模型会将当前模型上找不到的任何字段的查找 委托 给”子”模型。委托通过在父模型上自动设置的 Reference 字段来执行。
主要区别在于语义。使用委托时,模型是 拥有一个 而不是 是一个,使关系从继承变成了组合:
class Screen(models.Model):
    _name = 'delegation.screen'
    _description = 'Screen'

    size = fields.Float(string='Screen Size in inches')

class Keyboard(models.Model):
    _name = 'delegation.keyboard'
    _description = 'Keyboard'

    layout = fields.Char(string='Layout')

class Laptop(models.Model):
    _name = 'delegation.laptop'
    _description = 'Laptop'

    _inherits = {
        'delegation.screen': 'screen_id',
        'delegation.keyboard': 'keyboard_id',
    }

    name = fields.Char(string='Name')
    maker = fields.Char(string='Maker')

    # a Laptop has a screen
    screen_id = fields.Many2one('delegation.screen', required=True, ondelete="cascade")
    # a Laptop has a keyboard
    keyboard_id = fields.Many2one('delegation.keyboard', required=True, ondelete="cascade")
record = env['delegation.laptop'].create({
    'screen_id': env['delegation.screen'].create({'size': 13.0}).id,
    'keyboard_id': env['delegation.keyboard'].create({'layout': 'QWERTY'}).id,
})
record.size
record.layout
结果如下:
13.0
'QWERTY'
并且可以直接对委托字段进行写入:
record.write({'size': 14.0})
Warning
使用委托继承时,方法 不会 被继承,只有字段会
Warning
_inherits的实现多少有些不完整,如有可能请避免使用;链式
_inherits基本上没有实现,我们无法对最终行为做任何保证。
字段增量定义
字段定义为模型类上的类属性。如果模型被扩展,还可以通过在子类中重新定义同名同类型的字段来扩展字段定义。在这种情况下,字段的属性取自父类,并由子类中给出的属性覆盖。
例如,下面的第二个类仅为 state 字段添加了一个提示(tooltip):
class First(models.Model):
    _name = 'foo'
    state = fields.Selection([...], required=True)

class Second(models.Model):
    _inherit = 'foo'
    state = fields.Selection(help="Blah blah blah")
