绩效
性能剖析
性能剖析用于分析程序的执行情况并度量汇总数据。这些数据可以是每个函数的耗时、已执行的 SQL 查询…
虽然性能剖析本身并不会提升程序的性能,但它在发现性能问题并确定程序的哪一部分应对这些问题负责时非常有用。
Odoo 提供了一个集成的性能剖析工具,可记录执行期间所有已执行的查询和堆栈跟踪。它既可用于剖析用户会话的一组请求,也可用于剖析特定的代码片段。剖析结果既可以通过集成的 speedscope 可用于可视化火焰图的开源应用 视图来查看,也可以先用自定义工具将其保存为 JSON 文件或保存到数据库中再进行分析。
启用剖析器
剖析器既可以从用户界面启用(这是最简单的方式,但只能剖析 Web 请求),也可以从 Python 代码启用(可以剖析包括测试在内的任意代码片段)。
在开始剖析会话之前,必须在数据库上全局启用剖析器。可通过两种方式完成:
打开 开发者模式工具,然后切换 启用剖析 按钮。向导会提供一组剖析的到期时间供选择。点击 启用剖析 即可在全局启用剖析器。
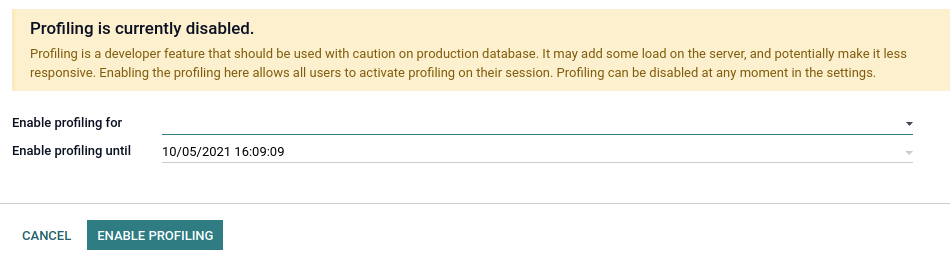
转到 设置 –> 通用设置 –> 性能,并在 启用剖析直到 字段中设置所需的时间。
在数据库上启用剖析器后,用户可以在自己的会话中启用它。为此,请再次切换 开发者模式工具 中的 启用剖析 按钮。默认情况下,推荐选项 记录 SQL 和 记录跟踪 已启用。要详细了解不同的选项,请参阅 收集器。
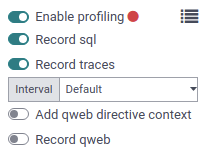
启用剖析器后,发往服务器的所有请求都会被剖析并保存到 ir.profile 记录中。这些记录会被归入当前的剖析会话,该会话的时间范围从启用剖析器开始直到其被禁用。
注解
Odoo Online 数据库无法进行剖析。
手动启动剖析器可以方便地剖析特定方法或代码的一部分。这段代码可以是一个测试、一个计算方法、整个加载过程等。
要从 Python 代码启动剖析器,请将其作为上下文管理器调用。可以通过参数指定要记录 什么。剖析测试类时有一个快捷方式 self.profile()。有关 collectors 参数的更多信息,请参阅 收集器。
示例
with Profiler():
    do_stuff()
示例
with Profiler(collectors=['sql', PeriodicCollector(interval=0.1)]):
    do_stuff()
示例
with self.profile():
    with self.assertQueryCount(__system__=1211):
        do_stuff()
注解
剖析器在 assertQueryCount 之外调用,以便捕获退出上下文管理器时(例如 flush)发出的查询。
启用剖析器后,测试方法的所有执行都会被剖析并保存到 ir.profile 记录中。这些记录会被归入同一个剖析会话。在使用 @warmup 和 @users 装饰器时,这尤其有用。
小技巧
分析被多次调用的方法的剖析结果可能很复杂,因为所有调用都归在一起显示在堆栈跟踪中。可以将 执行上下文 作为上下文管理器添加,以便将结果拆分为多个帧。
示例
for index in range(max_index):
    with ExecutionContext(current_index=index):  # Identify each call in speedscope results.
        do_stuff()
分析结果
要浏览剖析结果,请确保 剖析器已在数据库上全局启用,然后打开 开发者模式工具,并点击剖析区域右上角的按钮。此时会打开按剖析会话分组的 ir.profile 记录列表视图。
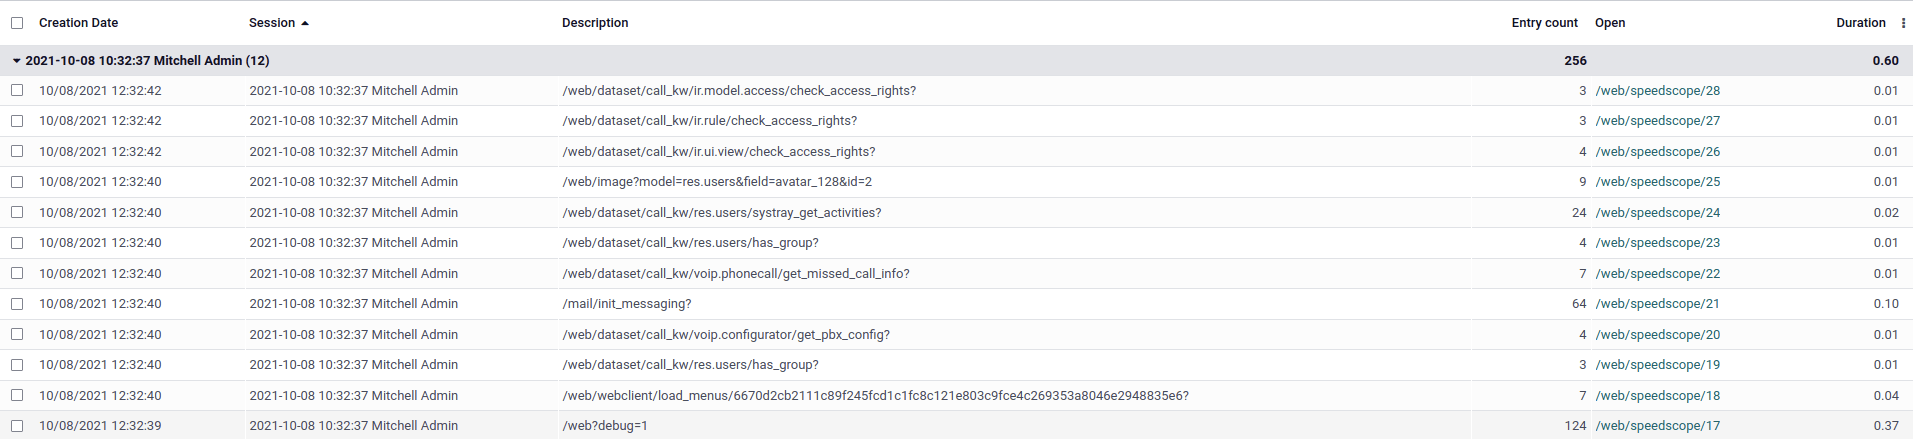
每条记录都有一个可点击的链接,可在新标签页中打开 speedscope 结果。
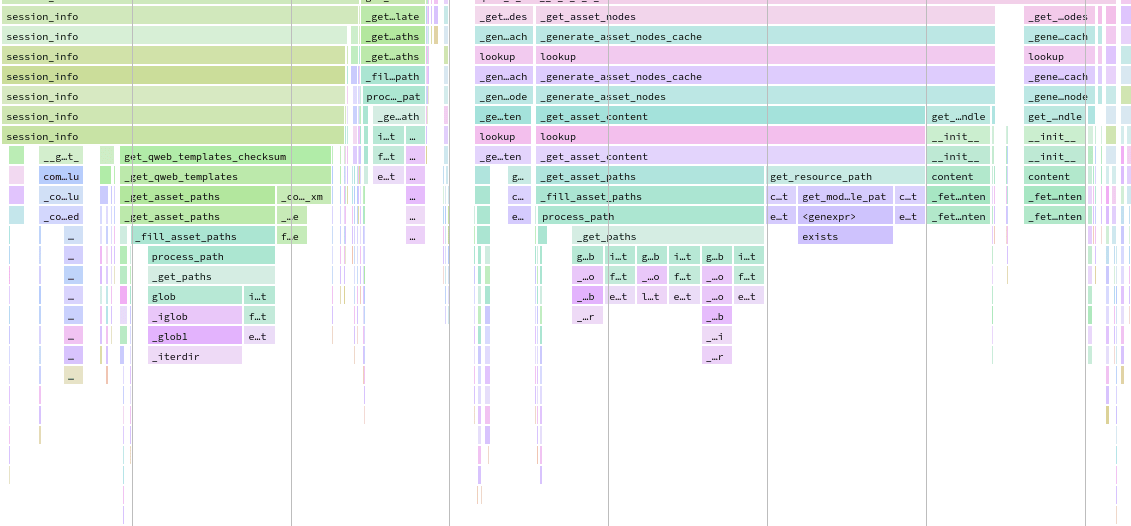
Speedscope 超出了本文档的范围,但有很多工具可以尝试:搜索、高亮相似帧、缩放帧、时间线、左偏重、三明治视图…
根据所激活的剖析选项,Odoo 会生成不同的视图模式,你可以从顶部菜单中访问它们。
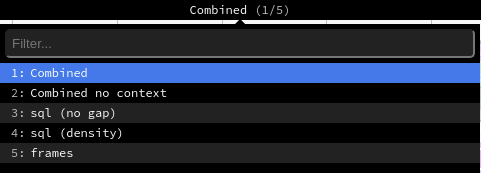
组合 视图显示合并在一起的所有 SQL 查询和跟踪。
组合(无上下文) 视图显示相同的结果,但忽略已保存的执行上下文 <performance/profiling/enable>`。
sql(无间隔) 视图显示所有 SQL 查询,就好像它们一个接一个地执行,不包含任何 Python 逻辑。这只适用于优化 SQL。
sql(密度) 视图仅显示所有 SQL 查询,并在它们之间留出间隔。这有助于判断问题出在 SQL 还是 Python 代码上,并找出可批量处理许多小查询的区域。
帧 视图仅显示 周期收集器 的结果。
重要
尽管剖析器的设计尽可能轻量,但它仍可能影响性能。在分析 speedscope 结果时请记住这一点。
收集器
剖析器负责的是剖析的 时机,而收集器负责的是 内容。
每个收集器都以其特有的格式和方式专门收集剖析数据。它们既可以在用户界面中通过 开发者模式工具 里各自的开关按钮单独启用,也可以在 Python 代码中通过其键或类启用。
目前 Odoo 中有三种可用的收集器:
名称 |
开关按钮 |
Python 键 |
Python 类 |
|---|---|---|---|
记录 SQL |
|
|
|
记录跟踪 |
|
|
|
记录 QWeb |
|
|
默认情况下,剖析器会启用 SQL 收集器和周期收集器,无论它是从用户界面启用还是从 Python 代码启用。
SQL 收集器
SQL 收集器会保存当前线程中(针对所有游标)对数据库执行的所有 SQL 查询以及堆栈跟踪。每条查询都会给被分析的线程增加该收集器的开销,这意味着在大量小查询上使用它可能会影响执行时间和其他剖析器。
它在调试查询数量时特别有用,也可用于在组合的 speedscope 视图中为 周期收集器 补充信息。
周期收集器
该收集器在单独的线程中运行,并在每个间隔保存被分析线程的堆栈跟踪。可以通过用户界面中的 间隔 选项或 Python 代码中的 interval 参数来定义该间隔(默认 10 毫秒)。
警告
如果将间隔设置得很低,剖析长时间请求时会导致内存问题。如果将间隔设置得很高,则会丢失有关短函数执行的信息。
由于使用单独的线程,它对执行时间的影响应该很小,因此这是分析性能的最佳方式之一。
QWeb 收集器
该收集器保存所有指令的 Python 执行时间和查询。与 SQL 收集器 一样,执行大量小指令时开销可能很可观。它的结果在收集的数据方面与其他收集器不同,可以在 ir.profile 表单视图中使用自定义小部件进行分析。
它主要用于优化视图。
性能陷阱
注意随机性。多次执行可能得出不同的结果。例如,剖析期间系统上还运行着其他进程或线程。
注意阻塞调用。在某些情况下,外部
c_call可能需要一段时间才会释放 GIL,从而导致 周期收集器 中出现意外的长帧。剖析器应能检测到这种情况并给出警告。如有需要,可以在这些调用之前手动触发剖析器。注意缓存。在
view/assets/… 进入缓存之前进行剖析可能会得出不同的结果。SQL 收集器 在大量小查询被执行时开销可能很可观。剖析便于发现问题,但为了衡量代码更改的真实影响,你可能需要禁用剖析器。
剖析结果可能占用大量内存。在某些情况下(例如剖析一次安装或一个长时间请求),你可能会达到内存上限,尤其是在渲染 speedscope 结果时,这可能导致 HTTP 500 错误。在这种情况下,你可能需要使用更高的内存限制来启动服务器:
--limit-memory-hard $((8*1024**3))。
良好实践
批量操作
处理记录集时,几乎总是最好批量执行操作。
示例
不要在遍历记录集时调用会执行 SQL 查询的方法,因为它会为集合中的每条记录都执行一次。
def _compute_count(self):
    for record in self:
        domain = [('related_id', '=', record.id)]
        record.count = other_model.search_count(domain)
相反,请用 _read_group 替换 search_count,以便为整批记录只执行一次 SQL 查询。
def _compute_count(self):
    domain = [('related_id', 'in', self.ids)]
    counts_data = other_model._read_group(domain, ['related_id'], ['__count'])
    mapped_data = dict(counts_data)
    for record in self:
        record.count = mapped_data.get(record, 0)
注解
此示例并非在所有情况下都是最优或正确的。它只是 search_count 的一种替代方案。另一种解决方案是预取并统计反向 One2many 字段。
示例
不要一条接一条地创建记录。
for name in ['foo', 'bar']:
    model.create({'name': name})
相反,请累积创建值并在批次上调用 create 方法。这样做基本没有副作用,而且有助于框架优化字段计算。
create_values = []
for name in ['foo', 'bar']:
    create_values.append({'name': name})
records = model.create(create_values)
示例
在循环中逐条浏览单个记录时未能预取记录集的字段。
for record_id in record_ids:
    model.browse(record_id)
    record.foo  # One query is executed per record.
相反,请先浏览整个记录集。
records = model.browse(record_ids)
for record in records:
    record.foo  # One query is executed for the entire recordset.
我们可以通过读取 prefetch_ids 字段来验证记录是否已批量预取,该字段包含每条记录的 id。若要把所有记录放在一起浏览则不切实际,
如有需要,可以使用 with_prefetch 方法来禁用批量预取:
for values in values_list:
    message = self.browse(values['id']).with_prefetch(self.ids)
降低算法复杂度
算法复杂度衡量的是算法相对于输入规模 n 完成所需的时间。当复杂度较高时,随着输入变大,执行时间会迅速增长。在某些情况下,可以通过正确地准备输入数据来降低算法复杂度。
示例
对于某个给定问题,我们考虑一个用两层嵌套循环编写的简单算法,其复杂度为 O(n²)。
for record in self:
    for result in results:
        if results['id'] == record.id:
            record.foo = results['foo']
            break
假设所有结果的 id 都不相同,我们可以预先准备数据来降低复杂度。
mapped_result = {result['id']: result['foo'] for result in results}
for record in self:
    record.foo = mapped_result.get(record.id)
示例
选择不恰当的数据结构来存放输入可能导致二次复杂度。
invalid_ids = self.search(domain).ids
for record in self:
    if record.id in invalid_ids:
        ...
如果 invalid_ids 是类似列表的数据结构,算法的复杂度可能是二次的。
相反,请优先使用集合操作,例如将 invalid_ids 转换为集合。
invalid_ids = set(invalid_ids)
for record in self:
    if record.id in invalid_ids:
        ...
根据输入的不同,也可以使用记录集操作。
invalid_ids = self.search(domain)
for record in self - invalid_ids:
    ...
使用索引
数据库索引可以帮助加快搜索操作,无论是在代码中搜索还是通过用户界面搜索。
name = fields.Char(string="Name", index=True)
警告
注意不要为每个字段都建立索引,因为索引会占用空间,并在执行 INSERT、UPDATE 和 DELETE 时影响性能。