ORM API 参考
型号
模型字段以属性的形式定义在模型自身上:
from odoo import models, fields
class AModel(models.Model):
    _name = 'a.model.name'

    field1 = fields.Char()
警告
这意味着您不能定义同名的字段和方法,后者会静默覆盖前者。
默认情况下,字段的标签(用户可见的名称)是字段名称的首字母大写形式,可通过 string 参数覆盖。:
field2 = fields.Integer(string="Field Label")
有关字段类型和参数的列表,请参阅 字段参考。
默认值通过字段参数定义,既可以直接给出一个值:
name = fields.Char(default="a value")
也可以通过调用一个函数来计算默认值,该函数应返回该值:
def _default_name(self):
    return self.get_value()

name = fields.Char(default=lambda self: self._default_name())
API
AbstractModel
模型
TransientModel
字段
基础字段
高级字段
日期(时间)字段
日期 和 日期时间 在任何类型的业务应用中都是非常重要的字段。误用它们可能造成难以察觉却令人痛苦的缺陷,本节旨在为 Odoo 开发者提供避免误用这些字段所需的知识。
为 Date/Datetime 字段赋值时,以下选项均有效:
一个
date或datetime对象。符合服务器格式的字符串:
YYYY-MM-DD用于Date字段,YYYY-MM-DD HH:MM:SS用于Datetime字段。
False或None。
Date 和 Datetime 字段类提供了辅助方法,用于尝试转换为兼容的类型:
to_date()会转换为datetime.dateto_datetime()会转换为datetime.datetime。
示例
要解析来自外部来源的日期/日期时间:
fields.Date.to_date(self._context.get('date_from'))
Date / Datetime 比较的最佳实践:
Date 字段 只能 与 date 对象进行比较。
Datetime 字段 只能 与 datetime 对象进行比较。
警告
表示日期和日期时间的字符串可以相互比较,但结果可能并非预期结果,因为日期时间字符串总是大于日期字符串,因此 强烈 不推荐这种做法。
日期和日期时间的常见操作(例如加法、减法或获取某个时间段的开始/结束时间)可通过 Date 和 Datetime 使用。导入 odoo.tools.date_utils 也可以使用这些辅助方法。
注解
时区
Datetime 字段在数据库中以 timestamp without timezone 列的形式存储,并以 UTC 时区存储。这是有意为之,因为它使 Odoo 数据库独立于托管服务器系统的时区。时区转换完全由客户端负责。
关系字段
伪关联字段
二进制字段
BinaryValue 表示一个可以延迟加载的字节(缓冲区)。这样就可以访问二进制字段,并将数据加载到内存的操作推迟到真正需要时再进行。二进制字段将始终返回该对象。您可以用 BinaryBytes() 来实例化它。
使用 odoo.orm.models.BaseModel.read() 时,读取到的是 base64 编码的字符串。写入二进制字段时,您可以:
写入
BinaryValue:一般情况在
raw字段上写入bytes:向后兼容写入 base64 编码的
str:来自 RPC 的值
计算字段
字段可以使用 compute 参数来计算(而不是直接从数据库读取)。它必须将计算出的值赋给该字段。如果它使用了其他 字段 的值,则应使用 depends() 指定这些字段。:
from odoo import api
total = fields.Float(compute='_compute_total')

@api.depends('value', 'tax')
def _compute_total(self):
    for record in self:
        record.total = record.value + record.value * record.tax
使用子字段时,依赖项可以是点分路径:
@api.depends('line_ids.value')
def _compute_total(self):
    for record in self:
        record.total = sum(line.value for line in record.line_ids)
计算字段默认不存储,它们在请求时计算并返回。设置
store=True会将其存储到数据库中,并自动启用搜索和分组。请注意,默认情况下该字段会设置compute_sudo=True。还可以通过设置
search参数来启用对计算字段的搜索。该值是一个返回 搜索域 的方法名。:upper_name = field.Char(compute='_compute_upper', search='_search_upper') def _search_upper(self, operator, value): if operator == 'like': operator = 'ilike' return Domain('name', operator, value)
计算字段默认是只读的。要允许在计算字段上 设置 值,请使用
inverse参数。它是指向一个函数的名称,该函数逆转计算过程并设置相关字段:document = fields.Char(compute='_get_document', inverse='_set_document') def _get_document(self): for record in self: with open(record.get_document_path) as f: record.document = f.read() def _set_document(self): for record in self: if not record.document: continue with open(record.get_document_path()) as f: f.write(record.document)
多个字段可以由同一个方法同时计算,只需在所有字段上使用相同的方法并将它们全部设置好即可:
discount_value = fields.Float(compute='_apply_discount')
total = fields.Float(compute='_apply_discount')

@api.depends('value', 'discount')
def _apply_discount(self):
    for record in self:
        # compute actual discount from discount percentage
        discount = record.value * record.discount
        record.discount_value = discount
        record.total = record.value - discount
警告
虽然可以对多个字段使用相同的计算方法,但不建议对反向方法也这样做。
在计算反向值时,所有 使用该反向方法的字段都会受到保护,这意味着它们无法被计算,即使其值不在缓存中。
如果访问了其中任一字段且其值不在缓存中,ORM 只会为这些字段返回默认值 False。这意味着反向字段(除触发反向方法的那个字段之外)的值可能不正确,这很可能会破坏反向方法的预期行为。
自动字段
- Model.id
标识符
字段如果当前记录集的长度为 1,则返回其中唯一记录的 id。
否则抛出错误。
- Model.display_name
Web 客户端中默认显示的名称
字段默认情况下,它等于
_rec_name值字段,但可以通过重写_compute_display_name来自定义该行为
访问日志字段
如果启用了 _log_access,这些字段会被自动设置和更新。可以将其禁用,以避免在那些用不到这些字段的表上创建或更新它们。
默认情况下,_log_access 被设置为与 _auto 相同的值
- Model.create_date
存储记录的创建时间,
Datetime
- Model.create_uid
存储 谁 创建了记录,指向
res.users的Many2one。
- Model.write_date
存储记录最后更新的时间,
Datetime
- Model.write_uid
存储最后更新该记录的人,指向
res.users的Many2one。
警告
_log_access 在 TransientModel 上 必须 启用。
保留字段名
除了自动字段之外,还有一些字段名被保留用于预定义的行为。当需要相应行为时,应在模型上定义这些字段:
- Model.name
用作
_rec_name的默认值,用于在需要代表性“名称”的场景中显示记录。Char
- Model.active
切换记录的全局可见性;如果
active被设为False,该记录在大多数搜索和列表中不可见。Boolean特殊方法:
- Model.state
对象的生命周期阶段,由
fields上的states属性使用。Selection
- Model.parent_id
_parent_name的默认值,用于以树形结构组织记录,并启用域中的child_of和parent_of运算符。Many2one
- Model.parent_path
当
_parent_store设为 True 时,用于存储反映_parent_name树结构的值,并优化 搜索域 中的child_of和parent_of运算符。为使其正常工作,必须使用index=True声明。Char
- Model.company_id
用于 Odoo 多公司行为的主字段名。
由
:meth:~odoo.models._check_company用于检查多公司一致性。定义记录是在各公司之间共享(无值),还是仅特定公司的用户可访问。Many2one:type:res_company
约束与索引
与字段类似,你可以声明 Constraint、Index 和 UniqueIndex。属性名必须以 _ 开头,以避免与字段名冲突。
你可以自定义错误消息。它们既可以是字符串,此时其翻译将由内部反射的约束表提供;也可以是函数,接受 (env, diag) 作为参数,分别表示环境和 psycopg 诊断信息。
示例
class AModel(models.Model):
    _name = 'a.model'
    _my_check = models.Constraint("CHECK (x > y)", "x > y is not true")
    _name_idx = models.Index("(last_name, first_name)")
记录集
与模型和记录的交互通过记录集完成,记录集是同一模型记录的有序集合。
警告
与名称所暗示的相反,目前记录集是可能包含重复记录的。这一点在未来可能会改变。
在模型上定义的方法是在记录集上执行的,其 self 是一个记录集:
class AModel(models.Model):
    _name = 'a.model'
    def a_method(self):
        # self can be anything between 0 records and all records in the
        # database
        self.do_operation()
对记录集进行迭代会产生 单个记录 的新集合(即“单例”),这与对 Python 字符串迭代会产生单字符组成的字符串非常相似:
def do_operation(self):
    print(self) # => a.model(1, 2, 3, 4, 5)
    for record in self:
        print(record) # => a.model(1), then a.model(2), then a.model(3), ...
字段访问
记录集提供“Active Record”接口:可以直接将模型字段作为属性从记录中读写。
注解
在可能含有多条记录的记录集上访问非关联字段时,请使用 mapped():
total_qty = sum(self.mapped('qty'))
字段值也可以像字典项一样访问,对于动态字段名而言,这比 getattr() 更优雅、更安全。设置字段的值会触发数据库更新:
>>> record.name
Example Name
>>> record.company_id.name
Company Name
>>> record.name = "Bob"
>>> field = "name"
>>> record[field]
Bob
警告
对多条记录读取非关联字段时会引发错误。
访问关联字段(Many2one、One2many、Many2many) 始终 返回一个记录集,字段未设置时为空记录集。
记录缓存与预取
Odoo 会为记录的字段维护缓存,这样并非每次字段访问都要发出数据库请求,否则性能会非常糟糕。下面的示例只在第一条语句时查询数据库:
record.name             # first access reads value from database
record.name             # second access gets value from cache
为了避免一次只读取一条记录上的一个字段,Odoo 会根据一些启发式规则 预取 记录和字段,以获得良好的性能。一旦需要读取某条记录上的某个字段,ORM 实际上会在一个更大的记录集上读取该字段,并将返回的值存入缓存以供后续使用。预取的记录集通常就是通过迭代得到该记录的那个记录集。此外,所有简单的存储字段(boolean、integer、float、char、text、date、datetime、selection、many2one)都会一并获取;它们对应模型表的列,并在同一次查询中被高效地获取。
请看下面的示例,其中 partners 是一个包含 1000 条记录的记录集。如果没有预取,这个循环会向数据库发出 2000 次查询。有了预取,只会发出一次查询:
for partner in partners:
    print partner.name          # first pass prefetches 'name' and 'lang'
                                # (and other fields) on all 'partners'
    print partner.lang
预取同样适用于 次要记录:读取关联字段时,其值(即记录)会被订阅以便将来预取。访问其中一条次要记录时,会预取同一模型的所有次要记录。这使得下面的示例只产生两次查询,一次用于联系人,一次用于国家:
countries = set()
for partner in partners:
    country = partner.country_id        # first pass prefetches all partners
    countries.add(country.name)         # first pass prefetches all countries
更多内容
方法 search_fetch() 和 fetch() 可用于填充记录缓存,通常用于预取机制效果不佳的情况。
方法装饰器
环境
>>> records.env
<Environment object ...>
>>> records.env.uid
3
>>> records.env.user
res.user(3)
>>> records.env.cr
<Cursor object ...>
从另一个记录集创建记录集时,环境会被继承。可以使用环境获得另一个模型中的空记录集,并查询该模型:
>>> self.env['res.partner']
res.partner()
>>> self.env['res.partner'].search([('is_company', '=', True), ('customer', '=', True)])
res.partner(7, 18, 12, 14, 17, 19, 8, 31, 26, 16, 13, 20, 30, 22, 29, 15, 23, 28, 74)
有一些惰性属性可用于访问环境(上下文)数据:
常用的环境方法
修改环境
SQL 执行
环境上的 cr 属性是当前数据库事务的游标,允许直接执行 SQL,无论是对于难以用 ORM 表达的查询(例如复杂的连接),还是出于性能考虑:
self.env.cr.execute("some_sql", params)
警告
执行原生 SQL 会绕过 ORM,因而也绕过 Odoo 的安全规则。使用用户输入时请确保对查询进行了清洗,并且如果不是真的需要使用 SQL 查询,请优先使用 ORM 工具。
构建 SQL 查询的推荐做法是使用包装对象
execute_query() 环境方法可以一次性完成刷新(见后文)、执行和获取结果。为了将模型字段转换为 SQL 并构建查询,提供了一种有用的抽象,位于
示例
query = Query(self.env['model'])
query.add_where(SQL("%s > %s", query.table.some_field, 'test'))
query.select()
# SELECT model.id
# FROM model
# WHERE model.some_field > 'test'
关于模型需要知道的一件重要事情是,它们不一定立即执行数据库更新。实际上,出于性能原因,框架在修改记录后会延迟字段的重新计算。而且某些数据库更新也会被延迟。因此,在查询数据库之前,必须确保其中已有查询所需的相关数据。这一操作称为 刷新 (flushing),它会执行预期的数据库更新。
示例
# make sure that 'partner_id' is up-to-date in database
self.env['model'].flush_model(['partner_id'])

self.env.cr.execute(SQL("SELECT id FROM model WHERE partner_id IN %s", ids))
ids = [row[0] for row in self.env.cr.fetchall()]
在每次 SQL 查询之前,必须刷新该查询所需的数据。刷新有三个级别,每个级别都有自己的 API。既可以刷新所有内容,也可以刷新某个模型的所有记录,或某些特定记录。由于延迟更新通常能提升性能,我们建议在刷新时 尽量具体。
使用查询构建器和 execute_query 时,模型的刷新会基于 SQL 中的元数据进行。
由于模型使用同一个游标,而 Environment 持有多种缓存,因此当用原生 SQL 修改 数据库时,必须使这些缓存失效,否则后续对模型的使用可能变得不一致。在 SQL 中使用 CREATE、UPDATE 或 DELETE 时必须清除缓存,但 SELECT 不需要(它只是读取数据库)。
示例
# make sure 'state' is up-to-date in database
self.env['model'].flush_model(['state'])

self.env.cr.execute("UPDATE model SET state=%s WHERE state=%s", ['new', 'old'])

# invalidate 'state' from the cache
self.env['model'].invalidate_model(['state'])
# get name and country name for all records, flushing and joins are
# done automatically
query = Query(self.env['model'])
self.env.execute_query(query.select(SQL(query.table.name, query.table.country_id.name)))
与刷新类似,可以使整个缓存、某个模型所有记录的缓存,或特定记录的缓存失效。甚至可以只使某些记录或某个模型所有记录上的特定字段失效。由于缓存通常能提升性能,我们建议在使缓存失效时 尽量具体。
上述方法使缓存与数据库彼此保持一致。然而,如果计算字段的依赖项在数据库中已被修改,就必须通知模型,以便重新计算计算字段。框架需要知道的只有 哪些 记录上的 什么 字段发生了变化。
示例
# make sure 'state' is up-to-date in database
self.env['model'].flush_model(['state'])

# use the RETURNING clause to retrieve which rows have changed
self.env.cr.execute("UPDATE model SET state=%s WHERE state=%s RETURNING id", ['new', 'old'])
ids = [row[0] for row in self.env.cr.fetchall()]

# invalidate the cache, and notify the update to the framework
records = self.env['model'].browse(ids)
records.invalidate_recordset(['state'])
records.modified(['state'])
必须确定哪些记录已被修改。有很多方法可以做到这一点,可能涉及额外的 SQL 查询。在上面的示例中,我们利用 PostgreSQL 的 RETURNING 子句在不额外查询的情况下获取该信息。通过使缓存失效来让缓存保持一致后,在被修改的记录上使用已更新过的字段调用 modified 方法。
常用 ORM 方法
创建/更新
搜索/读取
字段
搜索域
搜索域是一种一阶逻辑谓词,用于筛选和搜索记录集。你可以用逻辑运算符将字段表达式上的简单条件组合起来。
Domain 可用作域的构建器。
# simple condition domains
d1 = Domain('name', '=', 'abc')
d2 = Domain('phone', 'like', '7620')

# combine domains
d3 = d1 & d2  # and
d4 = d1 | d2  # or
d5 = ~d1      # not

# combine and parse multiple domains (any iterable of domains)
Domain.AND([d1, d2, d3, ...])
Domain.OR([d4, d5, ...])

# constants
Domain.TRUE   # true domain
Domain.FALSE  # false domain
域可以是一个简单条件 (field_expr, operator, value),其中:
field_expr(str)当前模型的字段名,或通过点号表示法经由
Many2one进行的关系遍历,例如'street'或'partner_id.country'。如果该字段是日期(时间)字段,还可以使用'field_name.granularity'指定日期的一部分。支持的粒度有'year_number'、'quarter_number'、'month_number'、'iso_week_number'、'day_of_week'、'day_of_month'、'day_of_year'、'hour_number'、'minute_number'、'second_number'。它们都以整数作为值。
operator(str)用于将
field_expr与value进行比较的运算符。有效的运算符有:=等于
!=不等于
>大于
>=大于或等于
<小于
<=小于或等于
=?未设置或等于(若
value为None或False则返回真,否则行为与=相同)=like(以及not =like)将
field_expr与value模式进行匹配。模式中的下划线_表示(匹配)任意单个字符;百分号%匹配任意长度(包括零个字符)的字符串。like(以及not like)将
field_expr与%value%模式进行匹配。与=like类似,但在匹配前会用 ‘%’ 包裹valueilike(以及not ilike)不区分大小写的
like=ilike(以及not =ilike)不区分大小写的
=likein(以及not in)与
value中的任意一项相等,value应为项目的集合child_of是
value记录的子项(后代),value可以是单个项或项列表。会考虑模型的语义(即沿着
_parent_name指定的关系字段)。parent_of是
value记录的父项(祖先),value可以是单个项或项列表。会考虑模型的语义(即沿着
_parent_name指定的关系字段)。any(以及not any)如果通过
field_expr(Many2one、One2many或Many2many)进行关系遍历时的任一条记录满足所提供的域value,则匹配。field_expr应为字段名。any!(以及not any!)与
any类似,但会绕过访问检查。
value变量类型,必须能与指定字段(通过
operator)进行比较。
示例
要搜索名称为 ABC、且电话或手机号码包含 7620 的联系人:
Domain('name', '=', 'ABC') & (
  Domain('phone', 'ilike', '7620') | Domain('mobile', 'ilike', '7620')
)
要搜索至少有一行明细的产品处于缺货状态的待开票销售订单:
Domain('invoice_status', '=', 'to invoice') \
  & Domain('order_line', 'any', Domain('product_id.qty_available', '<=', 0))
要搜索所有在二月份出生的联系人:
Domain('birthday.month_number', '=', 2)
Domain 可用于把域序列化为 list,其中的元素是由 3 元素 tuple (或 list)表示的简单条件。这种序列化形式有时读写起来更快。域条件可以使用 前缀 记法的逻辑运算符组合。你可以用 '&' (AND)、'|' (OR)组合 2 个域,用 '!' (NOT)对 1 个域取反。
# parse a domain (from list to Domain)
domain = Domain([('name', '=', 'abc'), ('phone', 'like', '7620')])

# serialize domain as a list (from Domain to list)
domain_list = list(domain)
# will output:
# ['&', ('name', '=', 'abc'), ('phone', 'like', '7620')]
动态时间值
在搜索域的上下文中,对于 日期与日期时间字段,值可以是用户时区中相对于 现在 的某一时刻。系统提供了一种简单的语言来指定这些日期。它是由空格分隔的若干词项组成的字符串。第一个词项是可选的,取值为 “today”(午夜)或 “now”。之后每个词项以 “+”(加)、“-”(减)或 “=”(设)开头,后跟一个整数和日期单位,或一个小写星期名。
日期单位为:“d”(天)、“w”(周)、“m”(月)、“y”(年)、“H”(小时)、“M”(分钟)、“S”(秒)。对于星期名,“+” 和 “-” 表示下一个和上一个星期几(除非当前已处于该星期几),“=” 表示从周一开始的当前周。设置日期时,较小的单位(小时、分钟和秒)被置为 0。
示例
Domain('some_date', '<', 'now')  # now
Domain('some_date', '<', 'today')  # today at midnight
Domain('some_date', '<', '-3d +1H')  # now - 3 days + 1 hour
Domain('some_date', '<', '=3H')  # today at 3:00:00
Domain('some_date', '<', '=5d')  # 5th day of current month at midnight
Domain('some_date', '<', '=1m')  # January, same day of month at midnight
Domain('some_date', '>=', '=monday -1w')  # Monday of the previous week
删除
记录(集)信息
- odoo.models.env
返回给定记录集的环境。
typeEnvironment
作业
记录集是不可变的,但同一模型的记录集可以使用各种集合运算进行组合,并返回新的记录集。
record in set返回record(必须是只含 1 个元素的记录集)是否存在于set中。record not in set是相反的操作set1 <= set2与set1 < set2返回set1是否为set2的子集(后者表示严格子集)set1 >= set2与set1 > set2返回set1是否为set2的超集(后者表示严格超集)set1 | set2返回两个记录集的并集,即包含任一来源中所有记录的新记录集set1 & set2返回两个记录集的交集,即仅包含两个来源中同时存在的记录的新记录集set1 - set2返回一个新记录集,其中仅包含set1中 不在set2中的记录
记录集是可迭代的,因此可以使用常用的 Python 工具进行转换(map()、sorted()、ifilter() 等),但这些工具返回的是 list 或 iterator,从而无法在其结果上调用方法或使用集合运算。
因此,记录集提供以下操作,在可能的情况下会返回记录集本身:
筛选
地图
注解
自 V13 起,支持多关系字段访问,其工作方式与 mapped 调用相同:
records.partner_id  # == records.mapped('partner_id')
records.partner_id.bank_ids  # == records.mapped('partner_id.bank_ids')
records.partner_id.mapped('name')  # == records.mapped('partner_id.name')
排序
分组
继承与扩展
Odoo 提供了三种以模块化方式扩展模型的不同机制:
基于现有模型创建新模型,向副本中添加新信息,但保持原模块不变
原地扩展其他模块中定义的模型,替换先前的版本
将模型的某些字段委托给其所包含的记录
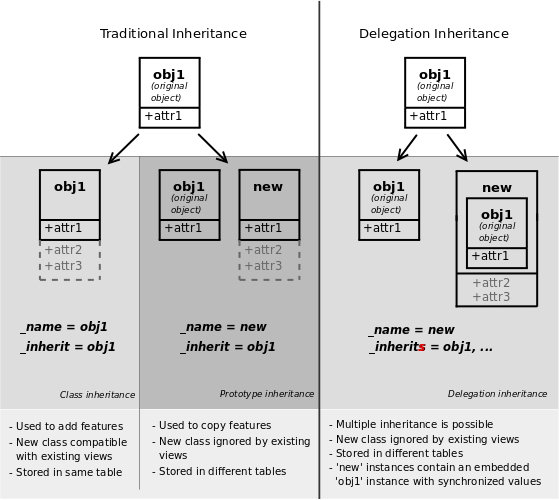
经典继承
同时使用 _inherit 和 _name 属性时,Odoo 会以现有模型(通过 _inherit 提供)为基础创建新模型。新模型从基类获得所有字段、方法和元信息(默认值等)。
class Inheritance0(models.Model):
    _name = 'inheritance.0'
    _description = 'Inheritance Zero'

    name = fields.Char()

    def call(self):
        return self.check("model 0")

    def check(self, s):
        return "This is {} record {}".format(s, self.name)

class Inheritance1(models.Model):
    _name = 'inheritance.1'
    _inherit = ['inheritance.0']
    _description = 'Inheritance One'

    def call(self):
        return self.check("model 1")
使用它们:
a = env['inheritance.0'].create({'name': 'A'})
b = env['inheritance.1'].create({'name': 'B'})

a.call()
b.call()
将会输出:
“这是模型 0 的记录 A” “这是模型 1 的记录 B”
第二个模型继承了第一个模型的 check 方法和 name 字段,但重写了 call 方法,与使用标准 Python 继承 时相同。
扩展
仅使用 _inherit 而不指定 _name 时,新模型会替换现有模型,实质上是在原地扩展它。这对于向现有模型(在其他模块中创建)添加新字段或方法,或对它们进行自定义或重新配置(例如更改其默认排序)都很有用
class Extension0(models.Model):
    _name = 'extension.0'
    _description = 'Extension zero'

    name = fields.Char(default="A")

class Extension0(models.Model):
    _inherit = 'extension.0'

    description = fields.Char(default="Extended")
record = env['extension.0'].create({})
record.read()[0]
将会输出:
{'name': "A", 'description': "Extended"}
警告
当 _inherit 设为字符串时,_name 也会被设为相同的值,除非显式设置了 _name。
注解
它还会生成各种 自动字段,除非这些字段已被禁用
委托
第三种继承机制提供了更大的灵活性(可以在运行时更改),但功能较弱:通过 _inherits,模型会把在当前模型上找不到的任何字段的查找 委托 给 “子” 模型。这种委托是通过在父模型上自动设置的 Reference 字段实现的。
主要区别在于含义。使用委托时,模型是 拥有一个 而不是 是一个,从而把关系变成组合而非继承
class Screen(models.Model):
    _name = 'delegation.screen'
    _description = 'Screen'

    size = fields.Float(string='Screen Size in inches')

class Keyboard(models.Model):
    _name = 'delegation.keyboard'
    _description = 'Keyboard'

    layout = fields.Char(string='Layout')

class Laptop(models.Model):
    _name = 'delegation.laptop'
    _description = 'Laptop'

    _inherits = {
        'delegation.screen': 'screen_id',
        'delegation.keyboard': 'keyboard_id',
    }

    name = fields.Char(string='Name')
    maker = fields.Char(string='Maker')

    # a Laptop has a screen
    screen_id = fields.Many2one('delegation.screen', required=True, ondelete="cascade")
    # a Laptop has a keyboard
    keyboard_id = fields.Many2one('delegation.keyboard', required=True, ondelete="cascade")
record = env['delegation.laptop'].create({
    'screen_id': env['delegation.screen'].create({'size': 13.0}).id,
    'keyboard_id': env['delegation.keyboard'].create({'layout': 'QWERTY'}).id,
})
record.size
record.layout
结果将会是:
13.0
'QWERTY'
也可以直接在委托字段上写入:
record.write({'size': 14.0})
警告
使用委托继承时,方法 不会 被继承,只有字段会被继承
警告
_inherits只是部分实现,能避免就尽量避免;链式
_inherits基本上没有实现,我们无法对最终行为做任何保证。
字段的增量定义
字段被定义为模型类上的类属性。如果模型被扩展,也可以通过在同名且同类型的子类上重新定义字段来扩展字段定义。在这种情况下,字段的属性取自父类,并由子类中给出的属性覆盖。
例如,下面的第二个类只为字段 state 添加了一个工具提示
class FirstFoo(models.Model):
    state = fields.Selection([...], required=True)

class FirstFoo(models.Model):
    _inherit = ['first.foo']
    state = fields.Selection(help="Blah blah blah")

class WrongFirstFooClassName(models.Model):
    _name = 'first.foo'  # force the model name
    _inherit = ['first.foo']
    state = fields.Selection(help="Blah blah blah")